
高质量数据集与"数据要素×":企业该怎么参与
栏目:技术洞察发布于:2026-10-02浏览:19923评论:0#数据要素#数据集
"数据要素×"三年行动计划(2024—2026)围绕多个行业给出了大量典型场景,核心意思是:让数据在具体场景里被反复使用,产生价值。同期推进的还有行业高质量数据集建设先行先试、"模数共振"行动等,指向的都是同一件事——模型与数据要互相牵引,单做一边都难以形成闭环。
一、对企业意味着什么
数据不是存着就有价值,要用起来才有。但在用之前,大部分企业的数据要过三关:
- 能找到:数据盘点与目录,知道有什么数据、在哪、谁负责;
- 能看懂:数据字典与口径定义,同一个字段在不同系统里含义要一致;
- 能合规用:分级分类与脱敏,明确哪些能用、用到什么程度、留痕怎么留。
这三关不过,后面的模型与应用都会反复返工:数据接进来了算不对,算不对就得回头查口径,查口径发现两个系统定义不一致——这是最常见的项目延期原因。
二、可行的参与路径
- 先做内部场景:选一个高频、痛点明确的业务场景,把相关数据整理成可用数据集,产生内部价值。这一步的价值最直接,也最容易获得内部支持;
-
再做行业共享:在合规前提下参与行业数据集建设,通过可信数据空间等机制对外提供;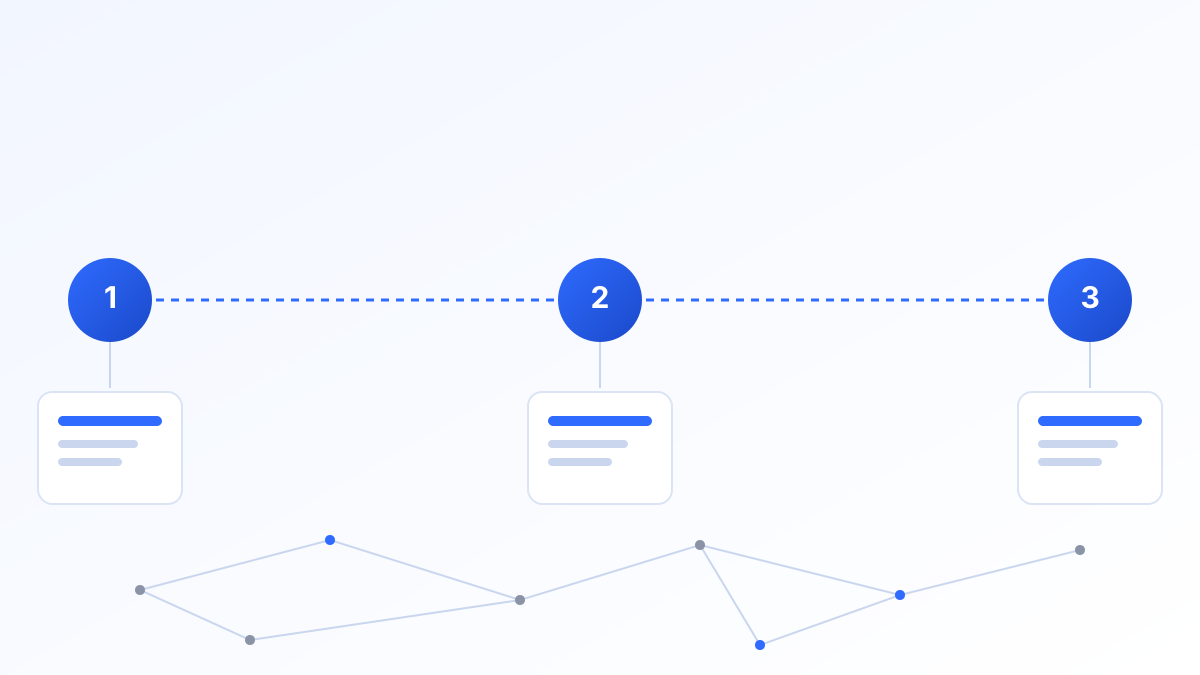
- 最后谈资产化:完成数据质量评估与合规审查后,才谈得上数据资产入表与流通。
顺序不能颠倒。跳过内部场景直接谈资产化,往往既看不到收益,也过不了评估。
三、内部怎么起步
- 选场景:优先选"数据已经产生、但没被系统用起来"的环节,比如历史工单、巡检记录、质检报告;
- 定口径:先写数据字典,把字段含义与取值范围固定下来,这一步决定数据集能否复用;
- 做数据集:清洗、标注、抽样质检,配套标注规范与质量抽检报告;
- 可评测:留出评测集,用具体任务(如问答命中率、分类准确率)检验数据集是否真的有用。
四、常见误区
- 一上来就要"把全公司数据治理好":通常做不完也看不到效果。正确做法是从一个场景切进去,做出成果再扩展——数据集是"用出来的",不是"治出来的";
- 把数据量当成质量:十万条未经清洗、口径混乱的记录,不如一万条标注规范、可追溯的数据;
- 忽视合规前置:涉及个人信息与重要数据时,先明确分级分类与脱敏规则,否则数据集做出来也不能用。
五、与 AI 应用的关系
数据治理与 AI 应用不应分两期做。实践中常见的问题是:第一期做数据治理,第二期做 AI 应用,结果第二期要返工重做第一期的数据——因为治理时没有按模型需求定义口径。
正确顺序是:用模型需求牵引数据治理,用高质量数据提升模型可用性。先确定要解决的问题和评测方式,再倒推需要哪些数据、治理到什么程度。这也是"模数共振"行动强调的核心逻辑。
六、边界
我们不承诺"数据集一定可以变现或入表"。数据资产化涉及质量评估、合规审查与确权等前置条件,我们能做的是把数据与文档准备到可评估、可审计的程度,最终结论应由专业机构与主管部门认定。
分享到:微博
评论(0)
还没有评论,来说两句吧